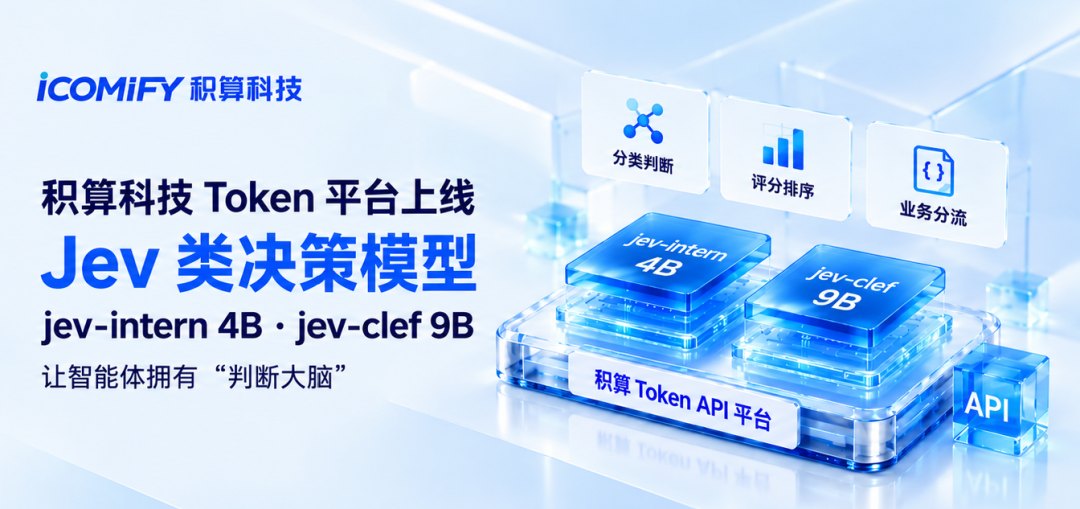
10月13日,北京积算科技有限公司(以下简称“积算科技”)Token平台正式上线jev-intern (4B)与jev-clef (9B)两款Jev类决策模型。两款模型面向企业自动化与智能体工作流中的高频判断需求,开发者可通过平台API直接调用,用于分类、评分、筛选与业务分流等判断任务。实测数据显示,Jev类模型处理速度最高可达其他参测大语言模型的170倍,助力智能体判断选择“更快更准”。
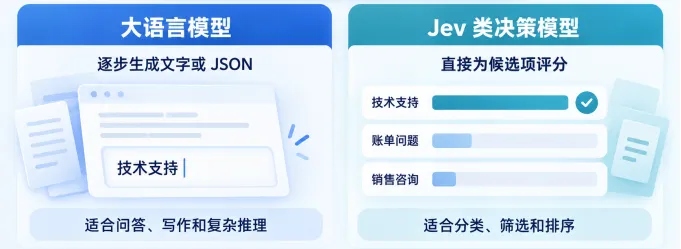
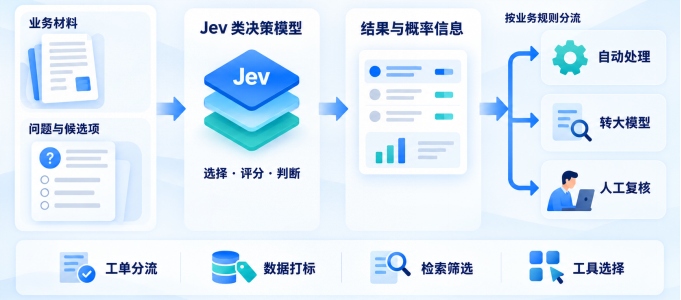
大语言模型擅长问答、写作与复杂推理,通常通过逐步生成文字或JSON来回答问题。不同于此,Jev类模型直接为候选项评分,将能力集中在“选哪个、是否符合、优先处理谁”这类明确判断上。
针对答案范围明确、调用频繁的任务,Jev类模型可在单次请求中并行处理多个预设问题,直接返回分类、评分及概率等结构化结果,无需逐Token生成完整回答,既减少了后处理步骤,也方便业务程序直接读取。
Jev类模型与大语言模型并非替代关系,而是可按任务需求组合使用:Jev类模型负责高频、明确、结构化的判断,大语言模型则负责复杂分析、内容生成与开放式规划,从而降低企业模型的整体调用成本。
积算科技率先完成两款Jev类模型(jev-intern 4B、jev-clef 9B)的适配部署,并同步接入Token平台。依托PD分离部署与动态批处理等底层能力,平台为决策模型提供了毫秒级响应支撑。开发者无需自备算力资源,即可通过API直接调用,快速开展分类、评分、筛选与业务分流等判断任务。
实测数据显示,两款Jev类模型表现优异:
判断质量:在意图识别、句子推理、应用分类等7项中文决策评测上,Jev-intern和Jev-clef的平均准确率分别为76.0%和78.4%,表现优于Deepseek-v4.1-flash的76.2%。
响应速度:Jev-intern的响应时间为120-600毫秒,处理速度为其他参测大语言模型的25-170倍;Jev-clef的响应时间为180-1100毫秒,处理速度为其他参测大语言模型的18-90倍。
这种“高准度+低延迟”的表现,大幅缩短了智能体在高频判断环节的响应等待时间,有效降低了计算开销。
两款Jev类模型提供不同参数规模选择,开发团队可根据自身业务数据评估判断质量、响应时间与调用成本,从一个明确的业务环节开始验证,再逐步扩展应用。
工单分流:根据工单内容判断问题类别、紧急程度与建议处理部门,输出分类结果与优先级评分,为后续工单自动分派与业务流转提供依据。
数据打标与资料整理:按业务标签识别文本主题、意图或情绪,输出标签与分数,辅助批量分类与数据整理。
检索筛选与排序:判断候选文档与用户问题的相关性,输出相关性评分,为后续问答筛选和重排提供依据。
智能体工具选择:根据当前任务,从已有工具中筛选适用选项并排序,为后续调用提供依据。
除上述两款Jev模型外,积算科技Token平台还集成了DeepSeek、Kimi、GLM、MiniMax、Qwen等主流开源大模型,并提供独有的多模融合Token服务,通过多模型协同进一步提升复杂任务的处理效果。
积算科技诞生于全球生成式人工智能浪潮,专注于智能算力服务市场,致力成为中国领先、专业的智能算力和Token服务商。公司拥有万卡级规模算力的Token工厂,提供裸金属算力、平台算力、私有化算力租赁、Token服务等产品;聚焦互联网、高校科研、AI科技、智能制造、服务等行业提供智能算力和Token服务。技术团队具备大规模智能算力系统设计和建设、模型训练和推理性能优化等服务能力,为各类企业建设Token工厂提供咨询服务和建设运维解决方案。
试用链接网址(或点击阅读原文):
https://maas.icompify.com/#/login
输入手机号,获取验证码并输入后即可进入token服务平台,实名认证并通过后即可试用