北京积算科技有限公司(以下简称"积算科技")Token 平台近日正式上线 DeepSeek V4.1 Flash 1017 版本模型。本次升级不改变调用方式:原有模型 ID 继续有效,开发者无需修改任何代码、无需重新对接,平台侧已完成权重替换,现有请求将自动切换至1017版本。
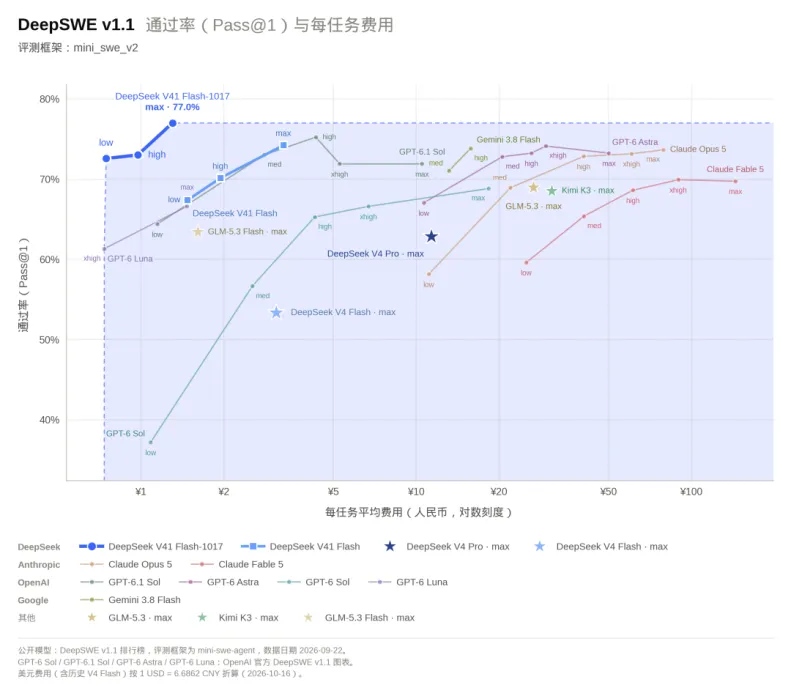
与上一版DeepSeek V4.1 Flash 相比,1017 版本在各项基准测试中均有长足提升,同时缩短了任务运行时间与输出长度。DeepSeek 将其定义为一次"性能–费用的帕累托改进":同样的预算,换来更高的任务完成度与更短的等待时间。模型延续 552B 参数的 MoE 架构与非对称 Causal-Encoder-Decoder 结构,输入侧激活 8B、输出侧激活 16B,原生支持视觉理解,上下文100万 token、最大输出 384K,并提供思考与非思考两种模式。
更直观的变化,是"许愿式编程"能力的落地。基于自反馈的强化学习训练,模型在较少提示词与素材参考下、极短交互轮次内即可从零构建完整项目,官方演示包括故宫 3D 建模、网页版赛车游戏、基于 Godot 引擎的《传送门 2》复刻与 Valley of Ages 3D 场景。工作流的起点就此前移:先让模型跑出一版可运行的完整工程,再由人判断、裁剪与优化,原型验证与 Demo 制作的周期被显著压缩。
Deepseek V4.1 Flash 1017 版本发布后,积算科技 Token 平台第一时间完成模型升级部署。针对DeepSeek v4.1的因果编码–解码架构,平台在推理服务栈中采用最新的技术,将 Prefill 计算量削减 30%~40%,高并发场景下首字时延(TTFT)降幅最高可达近 70%。使用用户实测反馈已由升级前的秒级降至 0.5秒左右,最快时仅0.17秒;吞吐性能较升级前提升约30%,达到150 tok/s左右,复杂长任务执行提速明显,使用体验很好;与此同时,平台围绕多模态输入、长上下文、工具调用与结构化输出四条主链路完成回归验证,确保版本切换对现有业务无感。接口层保持 OpenAI 兼容,同时支持 Responses API 与 Anthropic 格式,现有工具链应用可原样运行。
除 DeepSeek V4.1 Flash 外,积算科技 Token 平台还集成了 GLM、Kimi、Qwen 等主流开源大模型,以及 Jev 类决策模型与大语言模型形成能力互补。本次 DeepSeek V4.1 Flash 的升级着重针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等平台框架进行了适配优化,以充分发挥新模型的工程能力。其中,使用 DeepSeek Harness 的开发者,建议将框架升级至 0.2.1-rc.1 及以上版本,以获得适配新版模型的最优体验。
积算科技诞生于全球生成式人工智能浪潮,专注于智能算力服务市场,致力成为中国领先、专业的智能算力和Token服务商。公司拥有万卡级规模算力的Token工厂,提供裸金属算力、平台算力、私有化算力租赁、Token服务等产品;聚焦互联网、高校科研、AI科技、智能制造、服务等行业提供智能算力和Token服务。技术团队具备大规模智能算力系统设计和建设、模型训练和推理性能优化等服务能力,为各类企业建设Token工厂提供咨询服务和建设运维解决方案。
试用链接网址(或点击阅读原文):
https://maas.icompify.com/#/login
输入手机号,获取验证码并输入后即可进入token服务平台,实名认证并通过后即可试用